
Cloudflare D1 Time Travel로 데이터베이스를 안전하게 복구하는 방법
복구 가능 기간과 파괴적 복원을 구분하기
Cloudflare D1의 Time Travel 기능으로 과거 시점의 데이터베이스를 복구하는 절차와, 복원이 제자리를 덮어쓰는 파괴적 작업이라는 점을 정리합니다.
목차
Cloudflare D1을 쓰다가 마이그레이션 실수나 잘못된 쿼리로 데이터를 망가뜨렸을 때, Time Travel 기능으로 과거 시점으로 되돌릴 수 있습니다. 다만 이 복원은 되돌리기 쉬운 작업이 아닙니다. 실행하는 순간 지금의 데이터베이스를 그 자리에서 덮어쓰기 때문에, 절차를 제대로 이해하지 못한 채 실행하면 복구하려던 문제보다 더 큰 손실을 만들 수 있습니다.
Time Travel이 무엇을 보장하고 무엇을 보장하지 않는지, 복구 가능 기간과 횟수 제한은 얼마인지, 그리고 실제 복원 전에 어떤 순서로 확인해야 안전한지를 정리합니다. 실제 운영 데이터베이스에 복원 명령을 실행하는 것은 이 글의 범위가 아닙니다.
D1을 쓰는 서비스를 운영하다 보면 “복구 기능이 있으니 안심”이라는 생각과 “복구 기능을 잘못 쓰면 더 위험하다”는 생각이 동시에 필요합니다. Time Travel은 분명히 유용한 안전망이지만, 그 안전망이 어떻게 동작하는지 모른 채 급한 상황에서 처음 써 보면 오히려 판단을 그르치기 쉽습니다. 이 글의 목표는 평소에 이 기능의 범위와 한계를 미리 알아 두어, 실제로 문제가 생겼을 때 당황하지 않고 순서대로 판단할 수 있게 하는 것입니다.
순서
- Time Travel이 보장하는 것과 보장하지 않는 것을 구분합니다.
- 복구 가능 기간과 횟수 제한을 확인합니다.
- 북마크를 조회하는 방법을 확인합니다.
- 복원이 실제로 하는 일을 이해합니다.
- 복원 전에 거쳐야 할 안전 절차를 정리합니다.
Time Travel이 보장하는 것과 보장하지 않는 것
Time Travel은 D1 데이터베이스를 만들면 자동으로 켜져 있는 기능입니다. 별도로 활성화하는 설정이 없고, 과거 시점을 조회하거나 그 시점으로 복원하는 작업 모두 추가 비용이 들지 않습니다. 이 점에서 Time Travel은 “복구용 로그를 계속 쌓아 두는 안전망”에 가깝습니다. 다만 Time Travel 명령을 쓰려면 Wrangler 3.4.0 이상이 필요하고, 데이터베이스가 D1의 최신 백엔드(wrangler d1 info로 확인하는 version: production)를 쓰고 있어야 합니다. version: alpha로 표시되는 오래된 데이터베이스는 Time Travel이 아니라 예전 방식의 스냅샷 백업 API만 지원하므로, 아래 명령을 실행하기 전에 먼저 이 버전을 확인해 두는 것이 안전합니다.
하지만 이 안전망에는 분명한 한계가 있습니다. 보장하는 범위와 보장하지 않는 범위를 나눠 보면 다음과 같습니다.
| 구분 | 내용 |
|---|---|
| 보장하는 것 | 켜고 끄는 설정 없이 항상 동작, 조회·복원 모두 무료, 분 단위로 과거 시점을 지정해 복원 가능 |
| 보장하지 않는 것 | 복구 가능 기간을 넘긴 시점으로의 복원, 다른 이름의 데이터베이스로 복사(fork/clone) 후 시험, 복원 중 진행 중이던 쿼리의 안전한 완료 |
가장 혼동하기 쉬운 지점은 “복원”과 “별도 백업”을 같은 것으로 여기는 것입니다. Time Travel은 정해진 기간 안에서만 되돌릴 수 있는 시점 복구 기능이고, 그 기간을 넘어서는 장기 보관이 필요하다면 별도의 백업 체계를 직접 갖춰야 합니다. Time Travel이 항상 켜져 있다는 사실이 “언제까지나 되돌릴 수 있다”는 뜻은 아닙니다.
복구 가능 기간과 횟수 제한
복구 가능 기간은 Workers 요금제에 따라 다릅니다.
| 요금제 | 복구 가능 기간 |
|---|---|
| Workers Paid | 최근 30일 이내의 원하는 분 단위 시점 |
| Workers Free | 최근 7일 이내의 원하는 분 단위 시점 |
이 기간을 넘긴 시점은 Time Travel로 되돌릴 방법이 없습니다. 예를 들어 Free 플랜에서 8일 전의 실수를 지금 발견했다면, Time Travel만으로는 그 시점으로 돌아갈 수 없다는 뜻입니다. 이런 상황에 대비하려면 정기적으로 별도 백업을 받아 두는 방법을 함께 갖춰야 합니다.
복구 가능 기간 외에도 짧은 시간 안에 반복 복원을 막는 횟수 제한이 있습니다. 데이터베이스 하나당 10분에 최대 10회까지만 복원을 실행할 수 있습니다. 자동화 스크립트로 복원을 반복 시도하도록 짜여 있다면 이 한도에 걸려 실패할 수 있다는 점을 염두에 둬야 합니다.
D1 자체에도 데이터베이스 크기와 쿼리 관련 한도가 있습니다. 데이터베이스 최대 크기는 Paid 플랜 10GB, Free 플랜 500MB이고, 계정당 전체 저장 용량은 Paid 1TB, Free 5GB입니다. 이 계정당 저장량은 기본 한도이며, Paid·Enterprise 플랜은 Cloudflare에 요청해 늘릴 수 있습니다. 복구 대상 데이터베이스가 이 한도에 가까운 크기라면, 복원 자체보다 먼저 이 한도를 넘기지 않았는지 확인하는 것이 안전합니다.
이 한도들은 “Time Travel이 아예 안 되는 상황”을 만들지는 않지만, 간접적으로 영향을 줄 수 있습니다. 예를 들어 데이터베이스가 한도에 매우 가까운 크기로 커진 상태에서 복원을 반복 시도한다면, 복원 자체의 문제가 아니라 데이터베이스 크기 한도나 쿼리 한도 때문에 애플리케이션이 다른 오류를 내는 상황과 복원 실패가 겹쳐 원인 파악이 더 어려워질 수 있습니다. 복원이 예상과 다르게 동작한다면, Time Travel 자체의 문제인지 다른 D1 한도에 걸린 것인지부터 구분해야 합니다.
북마크 조회하기
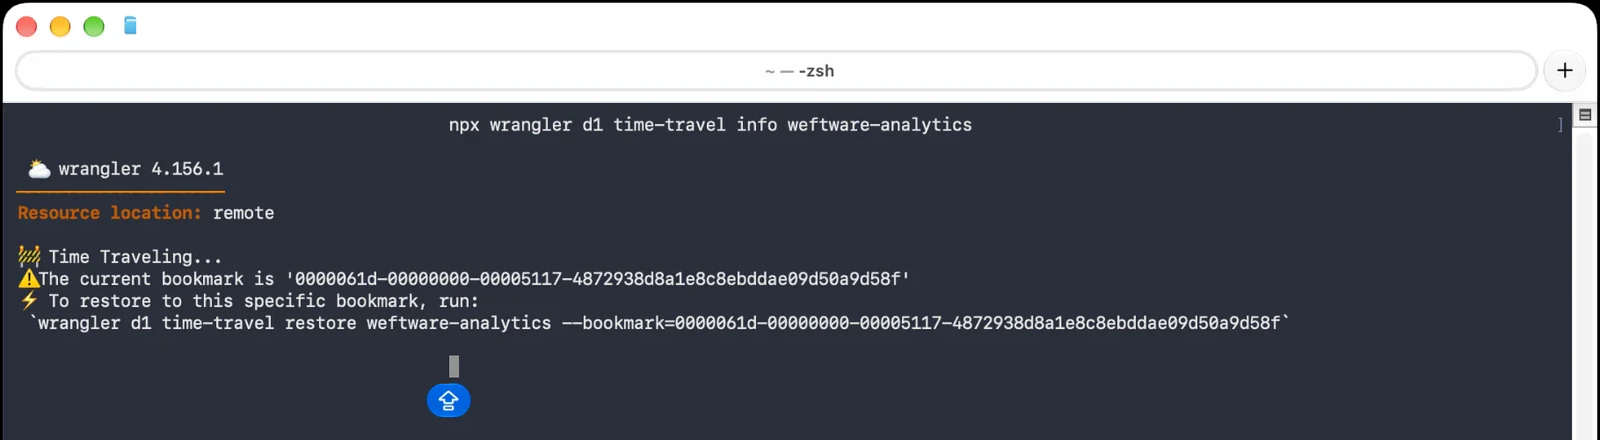
Time Travel은 특정 시점을 “북마크(bookmark)“라는 개념으로 표현합니다. 복원할 때 정확한 시각(UNIX 타임스탬프)을 직접 계산하는 대신, 북마크를 조회해서 쓸 수 있습니다.
wrangler d1 time-travel info YOUR_DATABASE현재 시점이 아니라 과거 특정 시각의 북마크를 확인하고 싶다면 --timestamp 옵션을 추가합니다.
wrangler d1 time-travel info YOUR_DATABASE --timestamp=2026-10-30T00:00:00Z이 조회 명령은 데이터베이스를 바꾸지 않는 읽기 전용 작업입니다. 복원을 실행하기 전에 먼저 이 명령으로 원하는 시점의 북마크가 실제로 존재하는지, 그 시점이 복구 가능 기간 안에 있는지부터 확인하는 것이 순서입니다.
이 명령들을 실행하려면 먼저 wrangler login으로 Cloudflare 계정에 로그인되어 있어야 하고, YOUR_DATABASE 자리에는 실제 데이터베이스의 이름이나 ID를 정확히 넣어야 합니다. 같은 계정에 비슷한 이름의 데이터베이스가 여러 개 있다면, wrangler d1 list로 전체 목록을 먼저 확인해 엉뚱한 데이터베이스를 지정하는 실수를 피하는 것이 안전합니다.
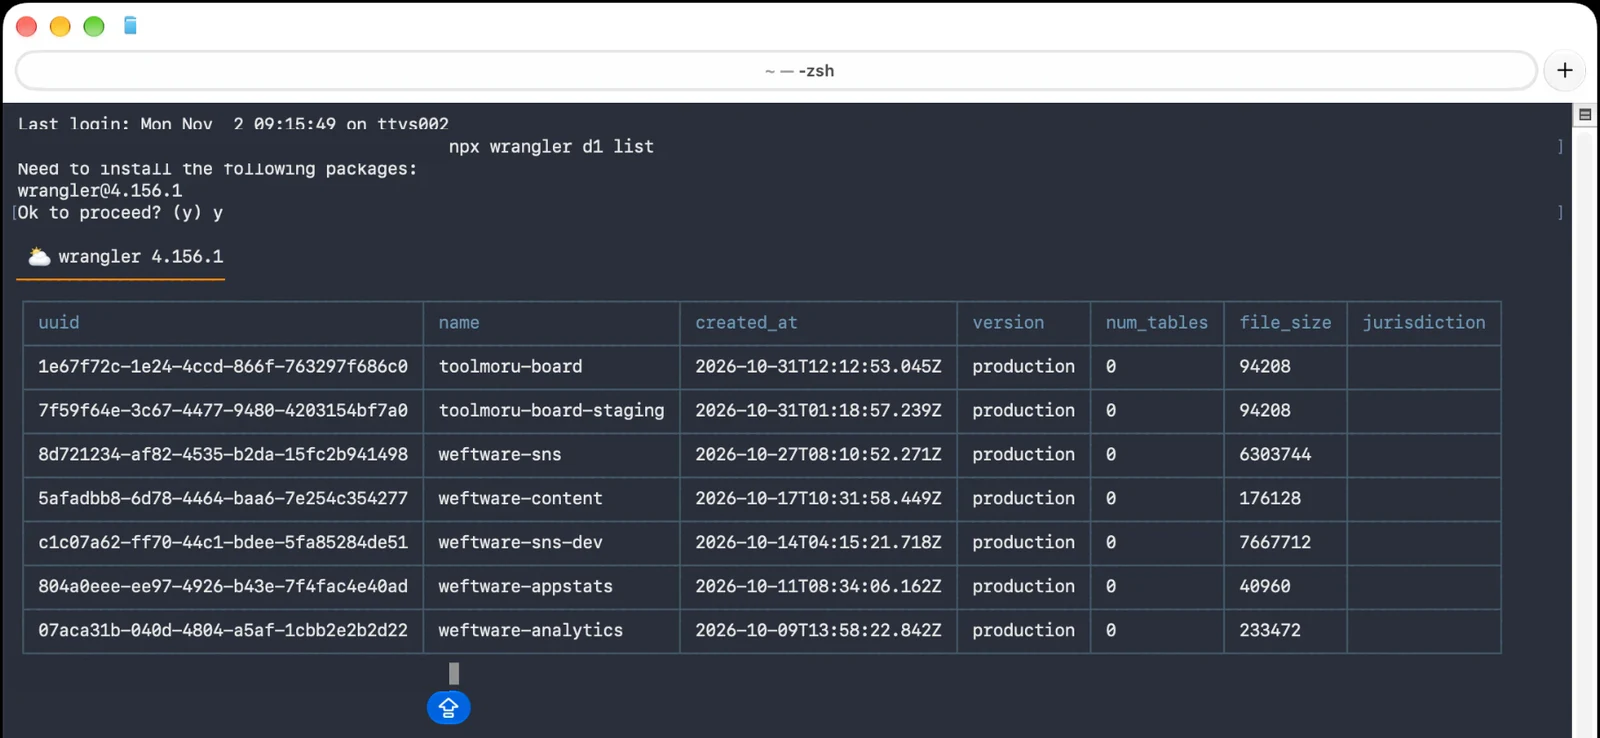
실제로 wrangler d1 time-travel info를 실행하면 아래처럼 현재 북마크 값이 그대로 출력됩니다.
복원이 실제로 하는 일
북마크를 확인했다면 다음은 실제 복원 명령입니다.
wrangler d1 time-travel restore YOUR_DATABASE --timestamp=UNIX_TIMESTAMP북마크 값을 직접 알고 있다면 --timestamp 대신 --bookmark 옵션으로도 지정할 수 있습니다.
이 명령을 실행하기 전에 반드시 이해해야 할 것은, 이 복원이 그 자리에서 데이터베이스를 덮어쓰는 파괴적 작업이라는 점입니다. 복원 시점 이후에 쌓인 모든 데이터, 복원 대상 시점에서는 정상이었지만 그 이후에 추가된 정당한 데이터까지 함께 사라집니다. 복원이 “문제가 된 부분만 골라서 되돌리는” 선택적 작업이 아니라, 데이터베이스 전체를 그 시점 상태로 되돌리는 전면적인 작업이라는 뜻입니다.
또한 복원이 진행되는 동안 그 데이터베이스에 연결된 애플리케이션이 실행하고 있던 쿼리와 트랜잭션은 취소되고, 클라이언트에는 오류가 반환됩니다. 운영 중인 서비스의 데이터베이스를 복원한다면, 복원이 끝날 때까지 일시적인 장애가 발생한다고 보고 준비해야 합니다.
복원 자체를 되돌릴 수는 있습니다. 복원 직전의 북마크를 기록해 뒀다면, 그 북마크로 다시 복원해 “되돌리기 전 상태(undo)“로 돌아갈 수 있습니다. 다만 이것도 결국 같은 파괴적 복원 작업을 한 번 더 실행하는 것이므로, 실수를 수습하는 안전망이지 공짜로 되돌릴 수 있는 기능은 아닙니다.
현재 Time Travel은 기존 데이터베이스를 새 이름의 복사본으로 만드는 fork나 clone 기능을 지원하지 않습니다. 그래서 “복원이 실제로 어떻게 될지 먼저 다른 데이터베이스에서 시험해 보고 싶다”는 요구를 지금 이 기능만으로는 채울 수 없습니다. 복원은 항상 원본 데이터베이스 자체에 바로 적용됩니다.
이 제약은 복원을 신중하게 결정해야 하는 이유이기도 합니다. 다른 많은 데이터베이스 서비스는 복원 전에 별도의 복사본을 만들어 먼저 그 결과를 확인해 볼 수 있지만, D1의 Time Travel은 그런 중간 확인 단계가 없습니다. 북마크 조회로 “어떤 시점이 존재하는지”는 미리 알 수 있어도, “그 시점으로 복원하면 데이터가 정확히 어떤 모습이 될지”는 실제로 복원을 실행해 봐야 확인할 수 있습니다. 이 때문에 복원 대상 시점을 고를 때는 여러 후보를 성급하게 시도해 보기보다, 가능한 한 정확한 근거(마이그레이션 배포 시각, 오류가 처음 발생한 시각 등)를 먼저 확보한 뒤 신중하게 시점을 하나로 좁히는 것이 안전합니다.
복원 전 안전 절차
실제 운영 데이터베이스에 복원을 실행하기 전에는 다음 순서를 권합니다.
- 지금 상태를 먼저 보존합니다. 복원하면 지금의 데이터가 사라지므로, 가능하다면 복원 전 상태를 별도로 내보내거나 백업해 둡니다.
export명령은 데이터베이스 이름과--output경로를 모두 지정해야 하며, 예를 들면 다음과 같습니다.
npx wrangler d1 export YOUR_DATABASE --remote --output=./d1-before-restore.sql다만 원격 데이터베이스를 대상으로 하는 이 내보내기는 작업 중 그 데이터베이스가 쿼리를 처리하지 못할 수 있다는 경고와 확인 프롬프트가 함께 뜨는 작업이라, 조회만큼 언제든 안전하지는 않습니다. 운영 중인 데이터베이스라면 이 내보내기도 트래픽이 적은 시간에 실행하는 것이 안전합니다. 명령이 끝나면 지정한 경로에 .sql 파일이 실제로 생성됐는지, 파일 크기가 0바이트는 아닌지 확인합니다. 파일이 만들어졌다는 사실만으로 그 안의 내용이 온전하다는 보장은 되지 않으므로, 꼭 필요한 백업이라면 파일을 열어 예상한 테이블과 데이터가 들어 있는지 한 번 확인하는 것이 안전합니다.
2. 복원할 정확한 시점의 북마크를 먼저 조회합니다. wrangler d1 time-travel info로 원하는 시점의 북마크가 실제로 존재하고, 복구 가능 기간 안에 있는지 확인합니다.
3. 복원 이후 사라질 데이터의 범위를 파악합니다. 복원 시점부터 지금까지 어떤 데이터가 쌓였는지, 그 데이터 중 정말 복원과 함께 사라져도 되는 것이 무엇인지 미리 정리합니다.
4. 운영 환경이라면 일시적인 쿼리 오류와 장애 가능성을 공지합니다. 복원 중에는 진행 중이던 쿼리와 트랜잭션이 취소되므로, 사용자나 다른 팀에 미리 알리는 것이 좋습니다.
5. 복원 직전의 북마크를 기록해 둡니다. 복원 결과가 기대와 다르다면 이 북마크로 다시 복원해 되돌릴 수 있습니다.
6. 복원 후에는 예상한 상태인지 검증합니다. 행 수, 주요 테이블의 최근 데이터, 스키마 버전처럼 복원 전후를 비교할 수 있는 기준을 미리 정해 두고, 복원이 끝난 뒤 그 기준으로 확인합니다.
이 순서의 2번부터 5번까지는 데이터베이스 내용을 바꾸지 않는 읽기·준비 단계입니다. 다만 1번의 원격 내보내기는 그 자체로 운영에 일시적인 영향을 줄 수 있으므로, 트래픽이 적은 시간을 골라 실행하는 것이 안전합니다. 실제로 데이터를 덮어쓰는 복원 명령은 이 목록에는 없고, 5번(복원 직전 북마크 기록)과 6번(복원 후 검증) 사이에 실행합니다. 이 복원 명령 한 번이 파괴적 작업이므로, 운영 데이터베이스라면 실행 권한과 절차를 미리 정해 두고 1–5번을 충분히 확인한 뒤에만 실행해야 합니다.
복원 전 “지금 상태”를 숫자로 확인해 두고 싶다면 wrangler d1 info도 참고할 만합니다. 테이블 수와 현재 데이터베이스 용량처럼, 복원 뒤에 비교할 기준을 미리 남겨 둘 수 있습니다.
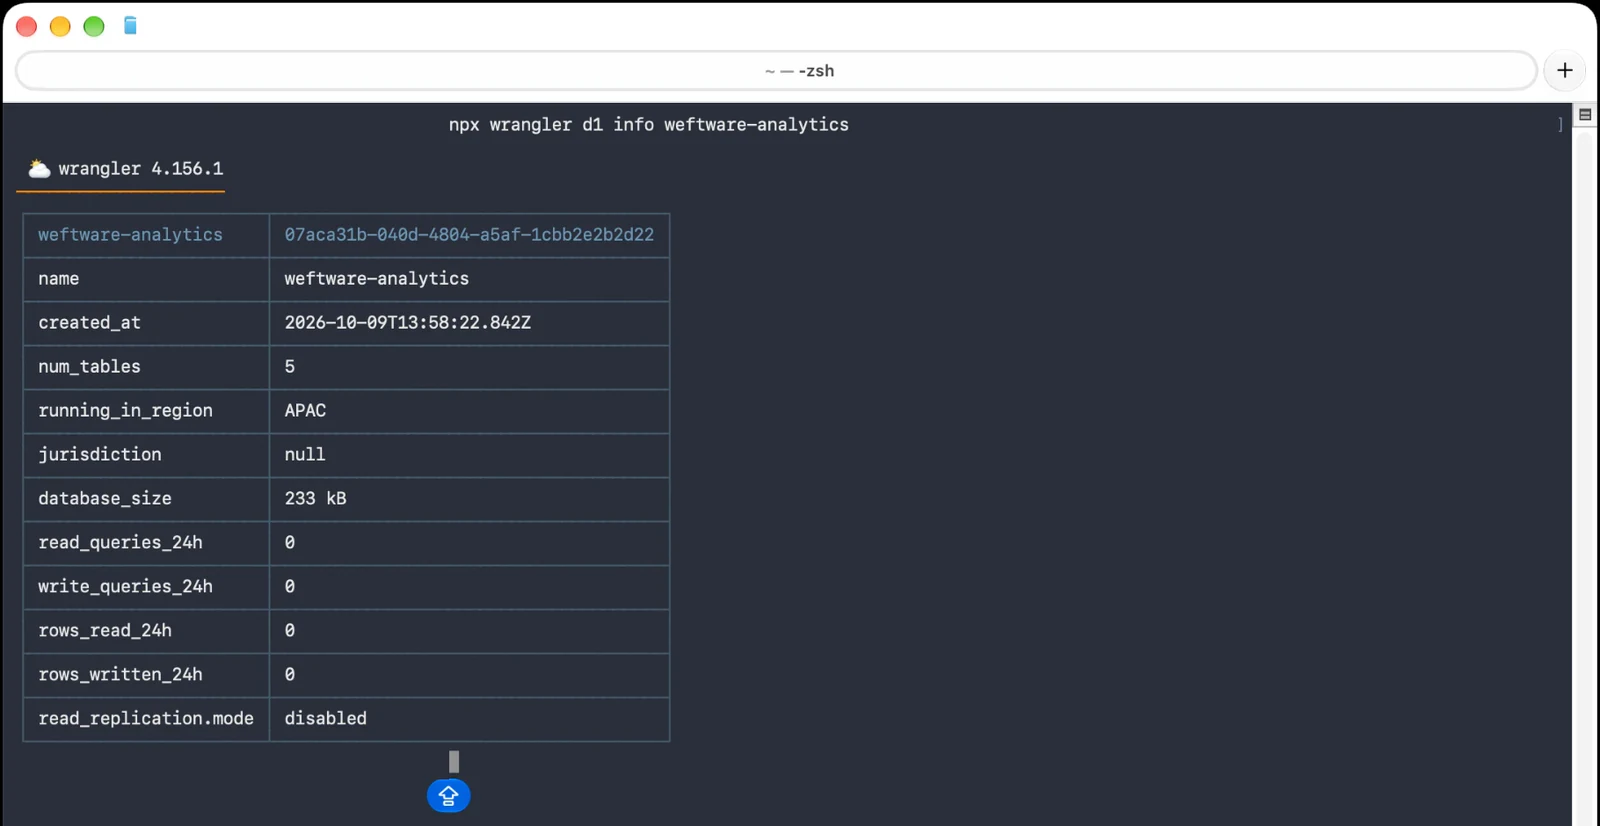
복원 권한을 누가 가져야 하는가
wrangler d1 time-travel restore 명령을 보통의 대화형 터미널에서 실행하면 “데이터베이스의 모든 데이터를 덮어쓴다”는 경고와 함께 OK to proceed (y/N) 확인 프롬프트를 띄우고, 여기서 y를 입력해야 실제로 복원이 진행됩니다. 다만 이 확인은 명령어 수준의 안전장치일 뿐이고, “지금 이 상황이 정말 복원까지 필요한지”, “이 사람이 복원을 실행해도 되는 권한이 있는지”를 가려 주지는 않습니다. 또한 --json 옵션을 붙여 실행하면 이 확인 프롬프트 자체가 뜨지 않고 곧바로 복원이 진행되므로, 자동화 스크립트에서 --json으로 호출하도록 짜여 있다면 실수로 잘못된 데이터베이스나 시점을 지정해도 그대로 실행될 위험이 남습니다. 그래서 조직 차원의 확인은 CLI의 확인 프롬프트가 항상 뜬다는 가정에 기대지 않고, 사람이 명령을 실행하기 전 단계에서 대상 데이터베이스와 시점을 직접 한 번 더 확인하는 절차로 갖춰야 합니다.
그래서 운영 데이터베이스에 대한 복원 권한은 실제로 복원이 필요한 상황이 생겼을 때만, 정해진 소수의 담당자가 정해진 절차를 거쳐 실행하는 것이 안전합니다. 평소 배포나 조회 작업을 하는 모든 사람이 복원 명령까지 아무 때나 실행할 수 있는 환경이라면, 의도하지 않은 실수(잘못된 데이터베이스 이름 입력, 잘못된 타임스탬프 복사 등)로도 똑같이 파괴적인 결과가 날 수 있습니다. 복원 명령을 실행하는 계정이나 토큰의 권한 범위를 필요한 사람에게만 열어 두고, 실행 전에 북마크와 대상 데이터베이스 이름을 한 번 더 확인하는 절차를 팀 차원에서 정해 두는 것이 실질적인 안전장치입니다.
복원이 필요한지 판단하기 전에
Time Travel을 쓸지 말지 고민하는 시점은 보통 이미 무언가 잘못됐다는 사실을 발견한 직후입니다. 이때 가장 먼저 해야 할 일은 복원 명령을 바로 실행하는 것이 아니라, 지금 상황이 정말 전체 시점 복원이 필요한 문제인지부터 가리는 것입니다.
문제의 범위가 특정 테이블의 특정 컬럼 몇 개로 좁혀진다면, 전체 데이터베이스를 과거 시점으로 되돌리는 것보다 그 범위만 바로잡는 수정 쿼리가 더 안전할 수 있습니다. 반대로 어떤 데이터가 잘못됐는지조차 파악하기 어렵고, 원인이 된 마이그레이션이나 배포 시점은 명확하다면 그 시점 직전으로 되돌리는 Time Travel이 더 확실한 해법이 될 수 있습니다. 이 판단을 서두르지 않는 것이 중요한 이유는, 복원을 실행하는 순간 그 판단을 되돌릴 수 있는 여지가 크게 줄어들기 때문입니다.
| 상황 | 더 적합한 선택 |
|---|---|
| 문제 범위(테이블·컬럼)를 정확히 특정할 수 있고, 그 이후 쌓인 다른 데이터는 지키고 싶음 | 수정 쿼리로 해당 범위만 고치기 |
| 어떤 데이터가 잘못됐는지조차 파악하기 어려움 | 원인 발생 시점 직전으로 Time Travel 복원 |
| 문제 발생 이후 쌓인 데이터(주문·결제 등)가 많고 되돌릴 수 없는 가치가 큼 | 복원보다 수정 쿼리나 수동 데이터 정리를 우선 검토 |
| 문제 발생 이후 쌓인 데이터가 거의 없거나 다시 만들어도 되는 데이터임 | Time Travel 복원 |
이 표는 절대적인 규칙이 아니라, 두 선택지 중 어느 쪽이 더 안전한지 가늠하는 출발점입니다. 실제 결정은 사라질 데이터의 범위와 가치를 구체적으로 확인한 뒤에 내려야 합니다.
실제로 복원해 검증한 결과
운영 데이터베이스가 아닌 별도 테스트용 D1(weftware-d1-time-travel-test)에서 복원이 실제로 어떤 결과를 내는지 끝까지 실행해 확인했습니다. 절차와 결과는 다음과 같습니다.
- 테이블을 만들고 레코드 10개(
note-1~note-10)를 입력했습니다. wrangler d1 time-travel info로 이 시점의 북마크를 받았습니다.- 레코드 5개(
note-11~note-15)를 추가하고,note-1·note-2의 내용을 각각CHANGED-1·CHANGED-2로 바꿨습니다. 이 시점에서 전체 레코드 수는 15개였습니다. - 2번에서 받은 북마크로
wrangler d1 time-travel restore를 실행했습니다. 복원은 약 3.3초 걸렸습니다. - 복원 후 다시 조회해 보니, 레코드 수는 정확히 10개로 돌아왔고(
note-11~note-15는 사라짐),note-1·note-2의 내용도 변경 전 값(original-1,original-2)으로 정확히 복원됐습니다.
이 결과는 두 가지를 실제로 확인해 줍니다. 북마크 시점 이후에 추가된 레코드는 예외 없이 사라진다는 것, 그리고 북마크 시점에 존재했던 레코드는 그 이후의 수정 내역과 무관하게 원래 값으로 되돌아온다는 것입니다. 테스트가 끝난 뒤 이 테스트용 데이터베이스는 삭제했습니다.
이 결과를 운영 상황에 적용하면, 복원 시점 이후에 생긴 데이터(여기서는 note-11 ~ note-15)는 복원과 동시에 전부 사라지므로, 복원을 결정하기 전에 그 구간의 데이터가 정말 버려도 되는지부터 확인해야 한다는 것이 구체적인 숫자로 확인됩니다.
별도 백업이 함께 필요한 이유
Time Travel이 항상 켜져 있고 무료라는 점 때문에, 별도 백업이 필요 없다고 오해하기 쉽습니다. 하지만 Time Travel은 어디까지나 정해진 기간 안의 시점 복구이지, 장기 보관을 위한 백업이 아닙니다.
복구 가능 기간을 넘긴 과거 시점은 Time Travel로 전혀 되돌릴 수 없습니다. 예를 들어 분기별 감사나 반기 단위 데이터 검증처럼 몇 달 전 상태를 참고해야 하는 상황이라면, Time Travel의 7일·30일 범위로는 전혀 대응할 수 없습니다. 이런 요구가 있다면 정기적으로 데이터베이스 내용을 내보내 별도로 보관하는 절차를 직접 갖춰야 합니다.
또한 Time Travel의 복원은 전체 데이터베이스를 한 시점으로 되돌리는 단일 작업이라, “이 테이블만 되돌리고 저 테이블은 그대로 둔다”처럼 선택적으로 적용할 수 없습니다. 복원 대상을 세밀하게 고를 수 있는 백업·복원 체계가 필요하다면, Time Travel과는 별도로 애플리케이션 수준에서 내보내기와 가져오기를 설계해야 합니다. Time Travel은 “최근 실수를 빠르게 되돌리는 안전망”으로, 장기 보관이나 선택적 복원이 필요한 백업 전략의 대체물로 보지 않는 것이 안전합니다.
마무리 정리
- Time Travel은 별도로 켜는 설정이 없고 항상 동작하며 조회와 복원 모두 무료이지만, 복구 가능 기간(Paid 30일, Free 7일)을 넘긴 시점은 되돌릴 수 없습니다.
- 복원은 데이터베이스를 그 자리에서 덮어쓰는 파괴적 작업입니다. 복원 시점 이후에 쌓인 정상 데이터까지 함께 사라지므로, 실행 전에 그 데이터가 정말 필요 없는지 확인해야 합니다.
- 복원 중에는 진행 중인 쿼리와 트랜잭션이 취소되고 클라이언트에 오류가 반환되므로, 운영 데이터베이스라면 일시적인 장애를 감안하고 미리 공지합니다.
- 데이터베이스당 10분에 10회라는 복구 횟수 제한이 있어, 자동화된 반복 복원 시도는 이 한도에 걸려 실패할 수 있습니다.
- 지금은 fork나 clone으로 복원 결과를 미리 시험해 볼 방법이 없으므로, 복원 전 북마크 조회와 데이터 범위 파악으로 최대한 안전하게 준비한 뒤 실행합니다.
- 별도 테스트 DB에서 직접 복원해 본 결과, 북마크 시점 이후 추가된 레코드는 예외 없이 사라지고 그 이전 레코드는 이후 수정 내역과 무관하게 원래 값으로 돌아왔습니다. 운영 데이터베이스에 적용하기 전에 이 동작을 미리 알아 두면 판단이 빨라집니다.
자주 묻는 질문
Time Travel을 따로 켜야 하나요?
켜고 끄는 설정 자체가 없습니다. 최신 백엔드(`version: production`)를 쓰는 D1 데이터베이스라면 만든 순간부터 항상 켜져 있는 상태이고, 기록 조회와 복원 모두 추가 비용이 들지 않습니다. 다만 오래전에 만들어 아직 `version: alpha`로 남아 있는 데이터베이스는 Time Travel이 아니라 이전 방식의 스냅샷 백업 API만 지원합니다.
복구 가능 기간은 얼마나 되나요?
Workers Paid 플랜은 최근 30일, Workers Free 플랜은 최근 7일 중 원하는 분 단위 시점으로 복구할 수 있습니다. 이 기간을 넘긴 시점은 Time Travel로 되돌릴 수 없습니다.
복원하면 그 이후에 쌓인 데이터는 어떻게 되나요?
복원은 데이터베이스를 그 시점 상태로 제자리에서 덮어쓰는 파괴적 작업입니다. 복원 시점 이후에 들어온 정상적인 데이터도 함께 사라지므로, 복원 전에 그 데이터가 정말 필요 없는지 확인해야 합니다.
다른 이름의 데이터베이스로 복사해서 먼저 확인해 볼 수 있나요?
이 글을 쓴 시점 기준으로 Time Travel은 기존 데이터베이스를 새 복사본으로 fork하거나 clone하는 기능을 지원하지 않습니다. 복원은 항상 원본 데이터베이스 자체를 덮어씁니다.
출처 및 참고자료
마지막 확인
- Cloudflare Docs · Time Travel and backups
- Cloudflare Docs · Limits